AI samenvatting maken: wat gaat verloren en hoe check je het
Een AI samenvatting maken geeft meestal een grotendeels juist resultaat, maar niet betrouwbaar. In een openbare benchmark liep het aandeel samenvattingen met ongedekte beweringen per model uiteen van ongeveer 2 tot 24 procent. Fouten zitten vooral in getallen, namen, ontkenningen en voorbehouden. Gebruik samenvattingen als kaart en check elk feit dat je wilt leren aan de bron.
Met AI een samenvatting maken van een tekst van 40 pagina's tot een overzicht van één pagina kost seconden, en het meeste wat erin staat klopt. Het probleem is het deel dat niet klopt, want dat ziet er precies hetzelfde uit als de rest. Een verkeerde datum, een weggevallen niet of een stellige bewering die de bron nooit deed, leest net zo soepel als de waarheid.
Voor studeren telt dat zwaarder dan bij het vluchtig bekijken van het nieuws. Je gaat onthouden wat de samenvatting zegt. Deze gids laat zien hoe de gemeten foutpercentages eruitzien, welke details vaak verloren gaan en een check van vijf minuten die de meeste problemen vangt.
Hoe nauwkeurig zijn AI-samenvattingen?
Dat hangt sterk af van het model. In het openbare klassement van Vectara, dat samenvattingen van korte documenten met de bron vergelijkt, liepen de hallucinatiepercentages bij 108 modellen uiteen van 1,8 tot 24,2 procent, met een mediaan rond 9,6 procent in september 2026.
Het Vectara hallucinatieklassement laat elk model dezelfde documenten samenvatten en gebruikt daarna een apart model om uitspraken te markeren die de bron niet ondersteunt. Het meet feitelijke consistentie, niet of de samenvatting nuttig is. Zo verdeelden de 108 vermelde modellen zich in de update van 22 september 2026.
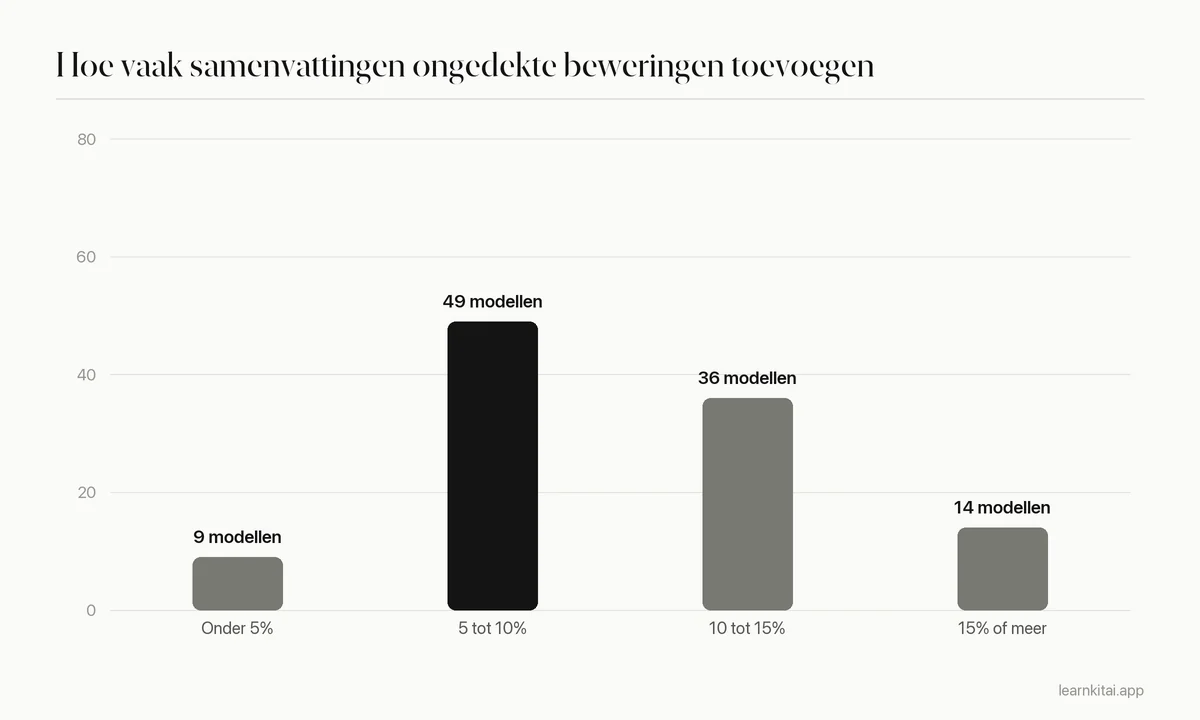
Twee dingen vallen op. Ook de beste modellen zijn niet perfect, en het typische model voegt aan ongeveer een op de tien samenvattingen een ongedekte bewering toe. De benchmark gebruikt bovendien vrij korte documenten. Lange hoofdstukken, gescande pagina's en collegetranscripten geven meer ruimte voor fouten.
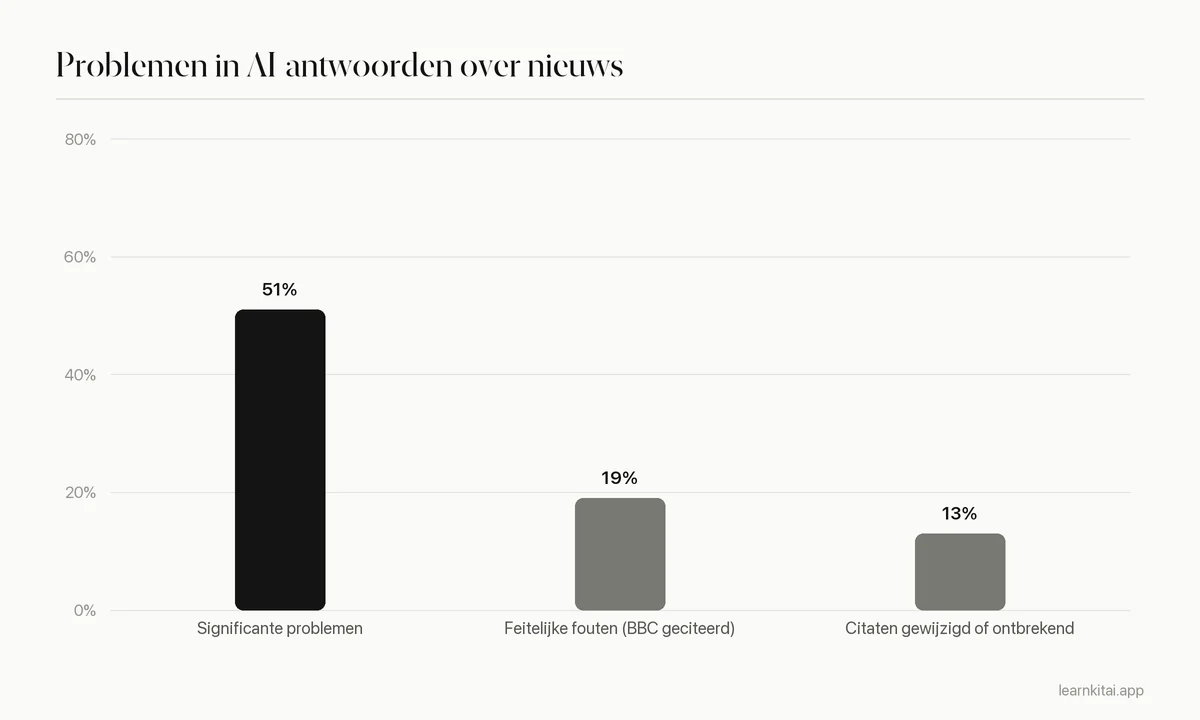
Praktijktests laten vergelijkbare problemen zien. Toen de BBC journalisten antwoorden van AI-assistenten over haar nieuwsberichten liet beoordelen, bleek 51 procent significante problemen te hebben, bevatte 19 procent van de antwoorden met BBC-inhoud feitelijke fouten zoals verkeerde getallen en data, en was 13 procent van de citaten gewijzigd of kwam niet voor in het aangehaalde artikel.
Wat gaat er in AI-samenvattingen vaak mis?
Kleine woorden met grote betekenis: getallen, data, namen, ontkenningen en voorbehouden als kan of in sommige gevallen. Ook worden uitzonderingen platgeslagen, gelijkende begrippen samengevoegd, wordt het midden van lange teksten ondergedekt en worden tabellen en figuren overgeslagen. Het grote verhaal klopt meestal. De details waarop tentamens toetsen zijn waar fouten zich verstoppen.
- Getallen en eenheden. Een stijging van 15 procent wordt 50 procent, of mg wordt g.
- Ontkenningen. Verhoogt het risico niet verliest zijn niet.
- Voorbehouden. Kan samenhangen met wordt veroorzaakt. In exacte vakken is dat een andere bewering.
- Uitzonderingen. Behalve bij kinderen verdwijnt, waardoor de regel algemeen lijkt.
- Gelijkende begrippen. Twee verwante enzymen, zaken of theoretici worden samengevoegd.
- Het midden van lange teksten. De dekking wordt vaak dunner in het midden van een lang hoofdstuk.
- Tabellen en schema's. Informatie die alleen in een figuur staat, kan worden overgeslagen of geraden.
Het probleem met het midden van de tekst is onderzocht. Een studie met de titel Lost in the Middle vond dat taalmodellen informatie het best gebruikten als die aan het begin of einde van een lange invoer stond, en dat de prestaties daalden als het relevante deel in het midden zat. Bij een lang hoofdstuk wijst dat erop dat je beter per onderdeel samenvat dan alles ineens.
Een uitgewerkt voorbeeld
Stel dat je leesstof farmacologie zegt: Bij volwassenen met een normale nierfunctie kan het middel de bloeddruk binnen twee uur verlagen; het wordt niet aanbevolen tijdens de zwangerschap. Een samenvatting zegt misschien: Het middel verlaagt de bloeddruk binnen enkele uren en wordt gebruikt tijdens de zwangerschap. Elk woord klinkt aannemelijk. Toch zijn er drie details veranderd: de voorwaarde (volwassenen met een normale nierfunctie) verdween, kan werd een zekerheid en het niet ging verloren, waardoor het veiligheidsadvies omdraaide. Dit is een illustratie, geen citaat van een echte tool, maar het laat het patroon zien waarop je moet letten.
Merk op dat een snelle lezing dit niet vangt. Je ziet het probleem pas als je de twee zinnen naast elkaar legt. Daarom richt de check hieronder zich op specifieke soorten woorden in plaats van op het herlezen van de hele samenvatting.
Hoe check je een AI-samenvatting in vijf minuten?
Vergelijk de opbouw van de samenvatting met de kopjes van de bron, controleer steekproefsgewijs elk getal en elke naam, zoek naar ontbrekende ontkenningen en voorbehouden en vraag de tool op welke pagina een bewering staat waaraan je twijfelt. Alles wat je wilt onthouden, bevestig je in de bron en niet in de samenvatting.
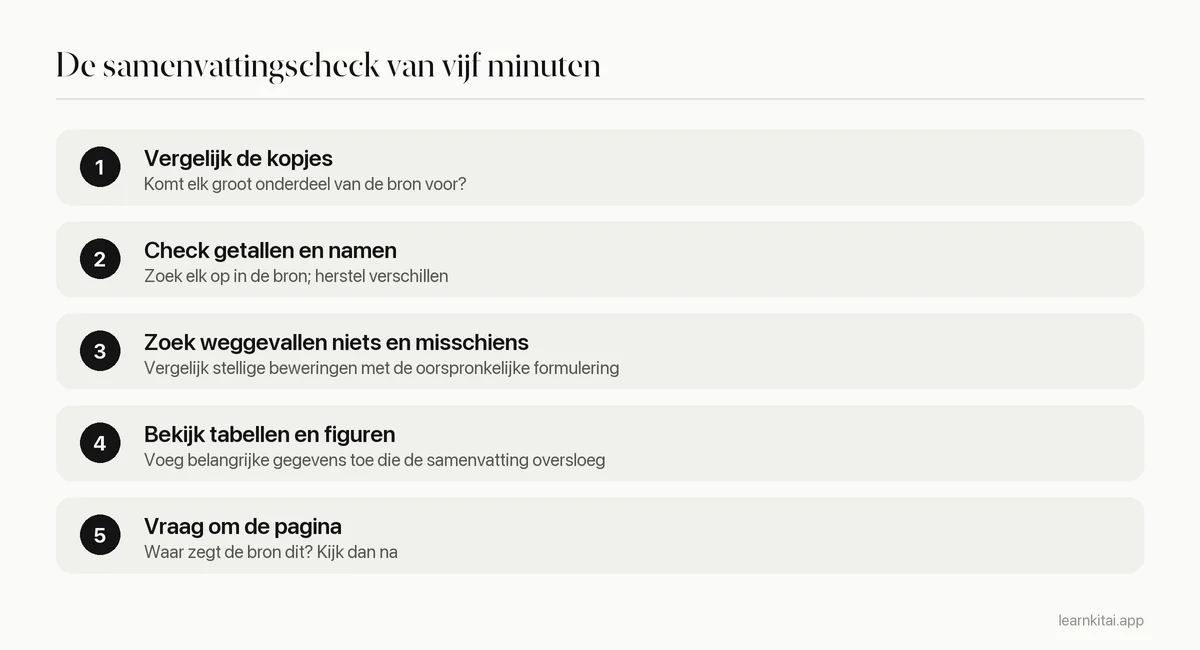
Je hoeft niet elke zin te controleren. Richt je op waarop je wordt getoetst: definities, getallen, stappen in een proces en beweringen met voorbehouden. Onze gids over AI-hallucinaties herkennen heeft een langere checklist voor stof waar veel op het spel staat, zoals geneeskunde en recht.
Is leren van een AI-samenvatting genoeg?
Nee. Zelfs een perfecte samenvatting is iets wat je leest, en alleen lezen is een zwakke manier om te leren. Leeronderzoekers beoordelen herlezen en samenvatten als weinig nuttig vergeleken met oefentoetsen. Gebruik de samenvatting om de structuur te zien en overhoor jezelf daarna op de inhoud.
Een veel aangehaald overzicht van studietechnieken beoordeelde samenvatten en herlezen als weinig nuttig, en oefentoetsen en gespreid oefenen als zeer nuttig. Een AI-samenvatting bespaart je leestijd, maar het lezen ervan blijft een vorm van herlezen. De waarde zit in wat je daarna doet.
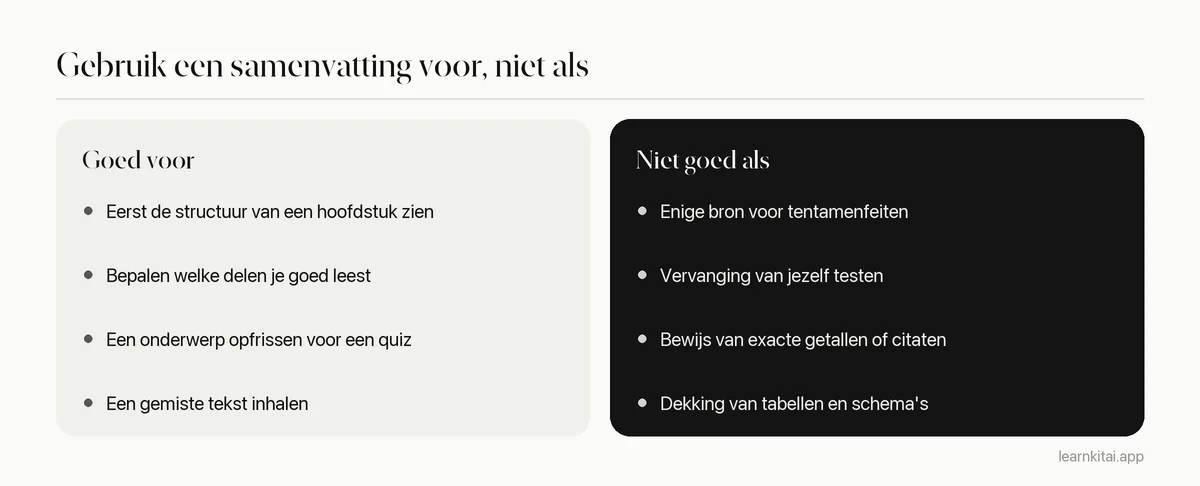
Een sterke routine: lees de samenvatting twee minuten voor de kaart, lees de bron met die kaart in gedachten, sluit dan beide en beantwoord vragen. Veel tools kunnen dezelfde bron omzetten in een quiz, zodat je de teststap zonder extra werk krijgt. Onze gids over een hoofdstuk samenvatten laat zien hoe je zelf een samenvatting schrijft als het samenvatten zelf het doel is.
Zo krijg je nauwkeurigere samenvattingen
- Geef schone tekst. Een pdf met tekst wint van een wazige foto. Moet je scans gebruiken, controleer dan eerst de herkende tekst.
- Vat per onderdeel samen. Eén onderdeel van een hoofdstuk tegelijk voorkomt dat het midden verloren gaat.
- Vraag om getallen en voorbehouden te behouden. Bijvoorbeeld: houd alle cijfers, eenheden en voorzichtige woorden precies zoals geschreven.
- Vraag om kernbegrippen met definities in de eigen woorden van de bron.
- Kies de lengte bewust. Zeer korte samenvattingen laten meer weg. Zie hoe lang een samenvatting moet zijn voor een vuistregel.
Een AI-samenvatting is een snelle, nuttige kaart met af en toe een verkeerde afslag. Weet waar fouten zich verstoppen, controleer de details die ertoe doen en ga van lezen naar testen. Voor het grotere plaatje zie je onze gids over AI om te studeren, en voor lange documenten onze gids over een pdf samenvatten.
Veelgestelde vragen
Hebben langere AI-samenvattingen minder fouten?
Niet per se minder fouten, maar ze laten minder details weg, zoals uitzonderingen en voorbehouden. Zeer korte samenvattingen moeten meer schrappen, dus belangrijke nuance verdwijnt eerder.
Zijn betaalde AI-samenvatters nauwkeuriger dan gratis?
Nauwkeurigheid hangt vooral af van het onderliggende model en de kwaliteit van de invoer, niet alleen van de prijs. Gratis limieten raken vaker de lengte dan de nauwkeurigheid. Controleer hoe dan ook de details die je gaat onthouden.
Kan een AI-samenvatter gescande pagina's en foto's aan?
Ja, maar de tekst moet eerst uit de afbeelding worden gelezen, en die stap kan fouten in getallen en symbolen veroorzaken. Controleer de herkende tekst voordat je de samenvatting vertrouwt, vooral bij formules en tabellen.
Mag ik een AI-samenvatting als eigen werk inleveren?
Meestal niet. De meeste scholen zien het inleveren van AI-tekst als eigen werk als schending van de regels, tenzij de opdracht het toestaat. Gebruik samenvattingen om te leren en schrijf ingeleverd werk zelf.
Bronnen
- Hallucination Leaderboard, Vectara (GitHub) (108 modellen, hallucinatiepercentages van 1,8 tot 24,2 procent, mediaan ongeveer 9,6 procent, bijgewerkt op 22 september 2026)
- BBC research shows issues with answers from artificial intelligence assistants, BBC Media Centre (51 procent significante problemen; 19 procent feitelijke fouten; 13 procent van de citaten gewijzigd of niet aanwezig)
- Lost in the Middle: How Language Models Use Long Contexts, Transactions of the Association for Computational Linguistics (Prestaties het hoogst als relevante informatie aan het begin of einde van lange invoer staat)
- Improving Students' Learning With Effective Learning Techniques, Psychological Science in the Public Interest (PubMed) (Samenvatten en herlezen beoordeeld als weinig nuttig; oefentoetsen zeer nuttig)
Lees verder
Studeren met AI: laat het je overhoren, niet voor je denken
AI kan je een sterkere student maken of een afhankelijkere. Het verschil is of AI het denkwerk doet of jou het denkwerk laat doen.
AI hallucinaties in je aantekeningen: check in 10 minuten
AI-aantekeningen kunnen perfect klinken en toch fout zijn. Leer waar fouten zich verstoppen en een snelle routine om ze te vangen voor je tentamen.
Een hoofdstuk samenvatten zodat je het nooit herleest
Veel hoofdstuksamenvattingen zijn kortere kopieën van het boek. De gesloten-boekmethode maakt van samenvatten oefening die blijft hangen, zodat je kunt leren van je eigen pagina.
Hulpmiddelen voor studeren met dyslexie: AI die voorleest
Dyslexie maakt lang lezen traag en vermoeiend, maar leren niet onmogelijk. Deze AI-tools verlagen de leeslast en verschuiven je inspanning naar onthouden.