KI Halluzinationen in Lernnotizen: 10-Minuten-Fehlercheck
KI-Halluzinationen sind selbstsichere Aussagen einer KI, die weder von deiner Quelle noch von der Realität gestützt werden. Um sie in Lernnotizen zu fangen: Erzeuge Notizen aus deinem eigenen Material, prüfe jede Zahl und jeden Namen stichprobenartig, verfolge einige Kernaussagen bis zur Seite zurück und frag dich ab, damit Lücken früh auffallen.
Eine Biologiestudentin zeigte uns einmal eine KI-Zusammenfassung, die wunderbar zu lesen war. Darin stand, mitochondriale Ribosomen seien „identisch mit den Ribosomen im Rest der Zelle“. Es klang richtig. Es war falsch: Sie ähneln bakteriellen Ribosomen, was Teil der Belege dafür ist, dass Mitochondrien einmal Bakterien waren. Dieser eine Satz hätte sie eine Prüfungsfrage gekostet. KI-Halluzinationen wie diese sind selten offensichtlich. Sie verstecken sich in flüssigem, selbstsicherem Text, und genau deshalb brauchst du eine Routine, um sie zu finden.
Dieser Ratgeber zeigt, wo sich Fehler in KI-Notizen gern verstecken, und gibt dir einen 10-Minuten-Check, den du bei jeder Zusammenfassung, jedem Karteikartenset und jedem Quiz machen kannst, bevor du daraus lernst.
Was sind KI-Halluzinationen, und warum entstehen sie?
Es sind Ausgaben, die selbstsicher klingen, aber weder von der Quelle noch von Fakten gedeckt sind. Sprachmodelle sagen wahrscheinlichen Text voraus, und die Forschung legt nahe, dass das Training eine gute Vermutung stärker belohnt als „Ich bin nicht sicher“, sodass eine flüssige falsche Antwort eine ehrliche Lücke schlagen kann.
Ein Sprachmodell schreibt ein wahrscheinliches Wort nach dem anderen. Meistens fallen wahrscheinlich und wahr zusammen. Tun sie es nicht, erzeugt das Modell trotzdem etwas, das sich gut liest. Ein Papier von OpenAI-Forschenden aus dem Jahr 2025 argumentiert, dass gängige Trainings- und Testmethoden Raten stärker belohnen, als Unsicherheit zuzugeben, ähnlich wie eine Multiple-Choice-Prüfung ohne Abzug für falsche Antworten. Ein Modell, das rät, schneidet bei vielen Benchmarks besser ab, also lernt es zu raten.
Für dich ist der praktische Punkt einfach: KI-Halluzinationen kündigen sich nicht an. Der Ton einer Antwort sagt nichts über ihre Richtigkeit. Ein falsches Datum klingt genauso sicher wie ein richtiges.
Wie oft erfindet KI Dinge?
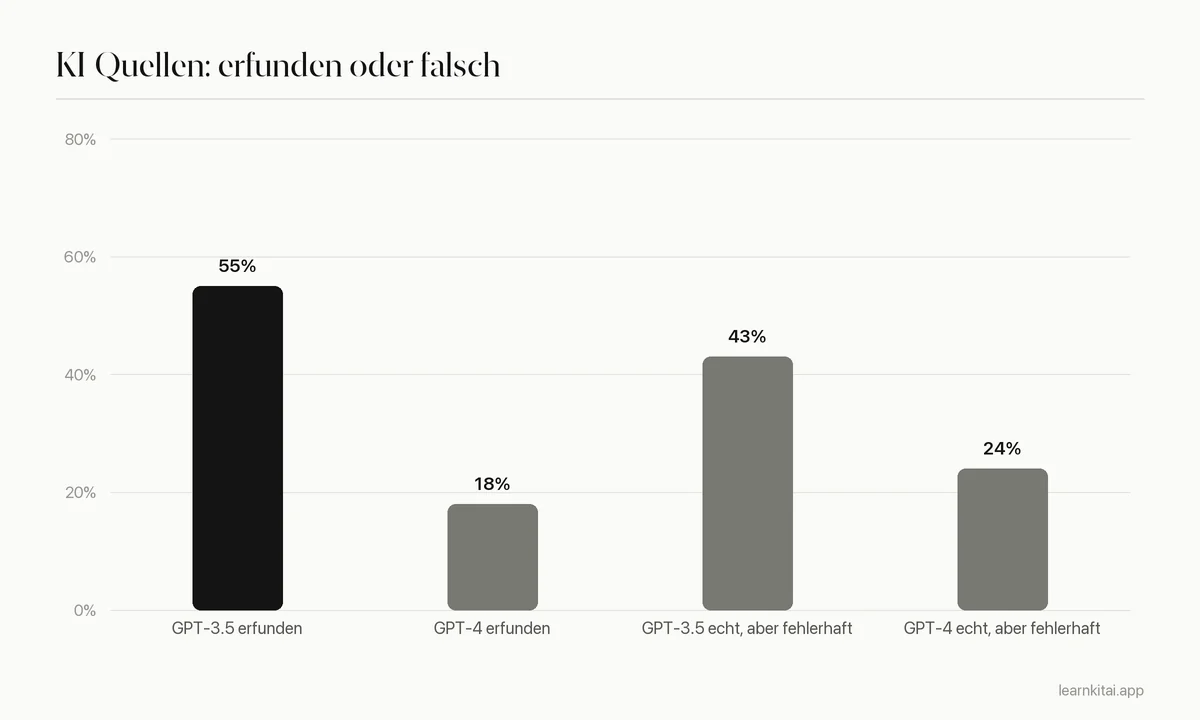
Das hängt stark vom Modell und von der Aufgabe ab. In einem bekannten Test erfanden ältere Chatbots über die Hälfte der Quellen, die sie angaben, und neuere erfanden noch fast jede fünfte. Offene Fragen ohne beigefügte Quelle sind am riskantesten.
Quellenangaben sind der klarste Test, denn ein Verweis existiert oder nicht. Die Forscher Walters und Wilder ließen ChatGPT kurze Literaturübersichten zu 42 Themen schreiben und prüften alle 636 Verweise. Sie fanden, dass 55 % der Quellen von GPT-3.5 und 18 % der Quellen von GPT-4 erfunden waren. Selbst unter den echten Verweisen hatten viele Fehler bei Details wie Seitenzahlen oder Daten.
Neuere Modelle schneiden besser ab, und Tools, die mit einem von dir gelieferten Dokument arbeiten, bleiben meist näher an den Fakten als ein Chatbot, der aus dem Gedächtnis antwortet. Aber besser heißt nicht perfekt. Die Gewohnheit, zu prüfen, kostet ein paar Minuten. Sie auszulassen kann eine Note kosten.
Wo verstecken sich Fehler in KI-Lernnotizen?
Die meisten Fehler häufen sich an wenigen Stellen: Zahlen und Einheiten, Namen und Daten, Quellenangaben, kleine Wörter wie „nicht“ oder „nur“ und Ursache-Wirkungs-Behauptungen. Prüfe sie zuerst, und du fängst die meisten Probleme schnell.
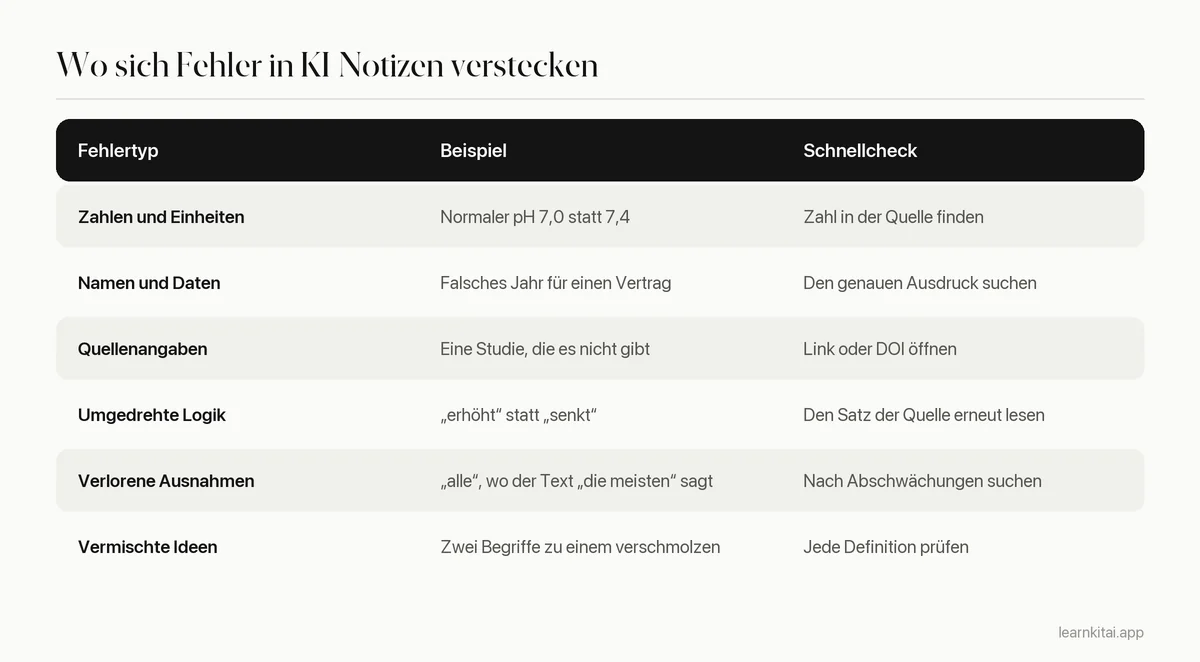
Umgedrehte Logik verdient besondere Aufmerksamkeit. Biologie- und Wirtschaftsnotizen sind voll von „erhöht“, „hemmt“ und „führt zu“. Eine Zusammenfassung, die einen Pfeil umkehrt, liest sich trotzdem glatt, und du lernst sie mit voller Überzeugung auswendig.
Wie prüfst du KI-Notizen in 10 Minuten auf Fehler?
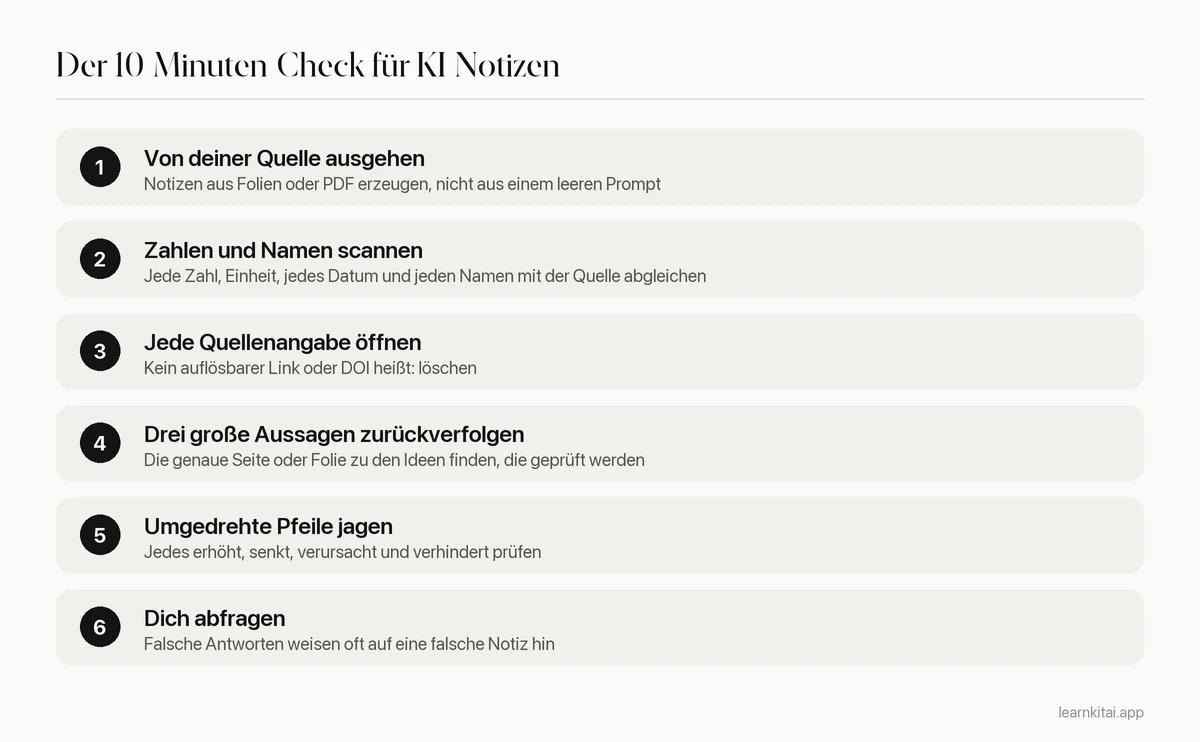
Arbeite von deiner eigenen Quelle aus und prüfe Zahlen, Namen und Quellenangaben dagegen. Verfolge drei Kernaussagen bis zur genauen Seite, such nach umgedrehter Logik und frag dich ab. Markiere die Notizen als geprüft, damit du es nur einmal tust.
Ein durchgerechnetes Beispiel
Angenommen, deine KI-Zusammenfassung einer Physiologie-Vorlesung enthält: „Insulin wird von den Alpha-Zellen der Bauchspeicheldrüse freigesetzt und erhöht den Blutzucker.“ Schritt zwei markiert „Alpha-Zellen“. Auf deiner Folie stehen Beta-Zellen. Schritt fünf markiert „erhöht“. Insulin senkt den Blutzucker; Glukagon erhöht ihn. Ein Satz, zwei Fehler, und beide hätten beim schnellen Lesen gut ausgesehen. Die Korrektur dauerte unter einer Minute, weil du die Quelle offen hattest.
Schritt sechs ist der stille Held. Wenn du dich aus deinen Notizen abfragst und sich eine Antwort falsch anfühlt, geh zurück zur Quelle statt zu den Notizen. Viele Studierende finden so Fehler, die ein sorgfältiges erneutes Lesen übersehen hat. Trage jeden in ein Fehlerprotokoll ein, damit du dir die Korrektur merkst und nicht den Fehler.
Ist KI genauer, wenn sie deine eigenen Dateien nutzt?
Meistens ja. Arbeitet ein KI-Tool mit einem Dokument, das du ihm gibst, hat es die Fakten vor sich, statt sie abzurufen, was erfundene Details tendenziell verringert. Fehler beseitigt es nicht, der Check gilt also weiterhin.
Deshalb zählt der erste Schritt am meisten. Frag einen allgemeinen Chatbot nach deinem Kurs, und er antwortet mit dem, was er im Training aufgenommen hat, das womöglich gar nicht zu deinem Lehrplan passt. Gib ihm dein echtes Vorlesungs-PDF, und er kann nah an dem bleiben, was deine Lehrperson vermittelt hat. Unser genauerer Blick auf die Genauigkeit von KI-Zusammenfassungen zeigt, wie Zusammenfassungen abdriften und worauf du achten musst.
LearnKit arbeitet so: Du fügst dein eigenes PDF, Notizen, ein Seitenfoto oder eine Vorlesungsaufnahme hinzu, und es baut Zusammenfassung, Karteikarten und Quiz aus dieser Quelle. Das Original neben der Zusammenfassung zu haben macht den 10-Minuten-Check leicht.
Bei welchen Dingen solltest du KI nie ungeprüft trauen?
Vertraue nie ungeprüften Quellenangaben, genauen Zahlen, Zitaten, juristischen oder medizinischen Einzelheiten oder allem, was deine Prüfung genau bewertet. Das sind die Details, bei denen KI am häufigsten falsch liegt und die am meisten Punkte kosten.
- Quellen und Zitate. Öffne jede. Existiert sie nicht, kommt sie weder in deine Notizen noch in deinen Essay.
- Formeln und Konstanten. Ein falscher Exponent verdirbt jede Aufgabe, die du damit löst.
- Dosierungen, Gesetze und Fallnamen. Genauigkeit zählt, und KI vermischt ähnliche Dinge oft.
- Die Definitionen deiner Lehrperson. Prüfungen erwarten oft die Formulierung des Kurses, keine allgemeine.
- Aktuelle Ereignisse. Ein Modell kennt womöglich Änderungen nicht, die nach dem Ende seiner Trainingsdaten liegen.
So genutzt spart dir KI echte Zeit. Du bekommst weiter schnelle Zusammenfassungen und sofortige Quizze. Du fügst nur zehn Minuten Prüfen hinzu, damit das Tempo nicht auf Kosten der Genauigkeit geht. Das große Bild, wo KI in deine Routine passt, findest du unter KI zum Lernen nutzen.
Häufige Fragen
Kann ich die KI ihre eigene Antwort prüfen lassen?
Ein wenig kann das helfen, etwa wenn du sie bittest, zu jeder Aussage den Satz der Quelle zu zitieren. Aber ein Modell kann den eigenen Fehler mit derselben Sicherheit wiederholen. Die echte Prüfung ist, selbst mit deiner Quelle zu vergleichen.
Sind KI-Karteikarten verlässlicher als KI-Zusammenfassungen?
Nicht von Natur aus. Karten sind kurz, sodass sich jede leicht prüfen lässt, aber eine falsche Karte wird durch Wiederholung ins Gedächtnis gedrillt. Prüfe die Karten vor deiner ersten Wiederholungseinheit, nicht danach.
Gibt es KI-Halluzinationen auch in Mathe?
Ja. KI kann sich verrechnen, Schritte überspringen oder eine falsche Formel selbstsicher nennen. Rechne jede Rechnung nach, aus der du lernen willst, und prüfe Formeln anhand deines Lehrbuchs.
Wie melde ich einen Fehler, den ich in KI-Notizen finde?
Korrigiere ihn sofort in deinen Notizen und markiere die Korrektur deutlich, etwa fett. Erlaubt das Tool, neu zu erzeugen oder zu bearbeiten, aktualisiere die Karte oder Zusammenfassung, damit du später nicht die falsche Version wiederholst.
Quellen
- Fabrication and errors in the bibliographic citations generated by ChatGPT, Walters and Wilder, Scientific Reports (via PubMed Central) (636 Quellenangaben geprüft: 55 % der Angaben von GPT-3.5 und 18 % von GPT-4 erfunden; 43 % und 24 % der echten hatten inhaltliche Fehler.)
- Why Language Models Hallucinate, Kalai, Nachum, Vempala and Zhang, arXiv (Argumentiert, dass Training und Bewertung Raten stärker belohnen als das Eingestehen von Unsicherheit.)
Weiterlesen
Mit KI lernen: Sie soll dich abfragen, nicht für dich denken
KI kann dich zu einer stärkeren oder zu einer abhängigeren Lernenden machen. Der Unterschied: Denkt sie für dich, oder bringt sie dich zum Denken?
KI Zusammenfassung: Was verloren geht und wie du prüfst
KI-Zusammenfassungen sind flüssig, schnell und meist weitgehend richtig. Hier siehst du, wo sie ausrutschen, und einen Fünf-Minuten-Check, bevor du daraus lernst.
KI und Plagiat: Wo Hilfe endet und Betrug beginnt
Das Werkzeug ist selten das Problem. Entscheidend ist, was du als dein eigenes Denken abgibst. Ein einfacher Test, um beim Lernen mit KI ehrlich zu bleiben.
Fehlerprotokoll lernen: Aus jedem Fehler Punkte machen
Ein Fehlerprotokoll ist eine einfache Tabelle jeder falsch beantworteten Frage samt Grund. Gut geführt wird es zum gezieltesten Lernleitfaden, den du je besitzen wirst.