AI 할루시네이션 잡기: 10분 노트 오류 점검
AI 할루시네이션은 AI가 내 자료나 현실에서 뒷받침되지 않는 내용을 자신 있게 말하는 것입니다. 공부 노트에서 잡으려면 내 자료로 노트를 만들고, 숫자와 이름을 모두 확인하고, 핵심 주장 몇 개를 원문 쪽수까지 추적하고, 스스로 퀴즈를 풀어 빈틈이 일찍 드러나게 하세요.
한 생물학 전공 학생이 아름답게 읽히는 AI 요약을 보여 준 적이 있습니다. 미토콘드리아 리보솜이 세포의 나머지 부분에 있는 리보솜과 동일하다고 쓰여 있었습니다. 그럴듯하게 들렸지만 틀렸습니다. 미토콘드리아 리보솜은 세균 리보솜을 닮았고, 이것이 미토콘드리아가 한때 세균이었다는 증거의 일부입니다. 그 한 문장이 시험 문제 하나를 날렸을 겁니다. 이런 AI 할루시네이션은 거의 눈에 띄지 않습니다. 유창하고 자신 있는 글 속에 숨어 있어서, 찾는 루틴이 필요합니다.
이 글은 AI 노트에서 오류가 어디에 숨는지 보여 주고, 요약, 플래시카드, 퀴즈로 공부하기 전에 어디에나 적용할 수 있는 10분 점검법을 알려 줍니다.
AI 할루시네이션이란 무엇이고 왜 생기나요?
자신 있게 들리지만 원문이나 사실이 뒷받침하지 않는 출력입니다. 언어 모델은 그럴듯한 글을 예측하고, 연구에 따르면 학습은 잘 모르겠다고 말하는 것보다 좋은 추측에 보상하기 때문에, 유창한 오답이 정직한 공백을 이길 수 있습니다.
언어 모델은 그럴듯한 단어를 하나씩 이어 씁니다. 대부분 그럴듯함과 사실이 일치합니다. 일치하지 않을 때도 모델은 읽기 좋은 무언가를 만들어 냅니다. OpenAI 연구자들의 2025년 논문은 일반적인 학습과 평가 방식이 불확실함을 인정하기보다 추측에 보상한다고 주장하는데, 오답에 감점이 없는 객관식 시험과 비슷합니다. 추측하는 모델이 많은 벤치마크에서 점수가 더 좋기 때문에 추측하도록 학습됩니다.
내게 실질적인 요점은 간단합니다. AI 할루시네이션은 스스로 알리지 않습니다. 답변의 어조는 정확도에 대해 아무것도 알려 주지 않습니다. 틀린 날짜도 맞는 날짜만큼 확신에 차게 들립니다.
AI는 얼마나 자주 지어내나요?
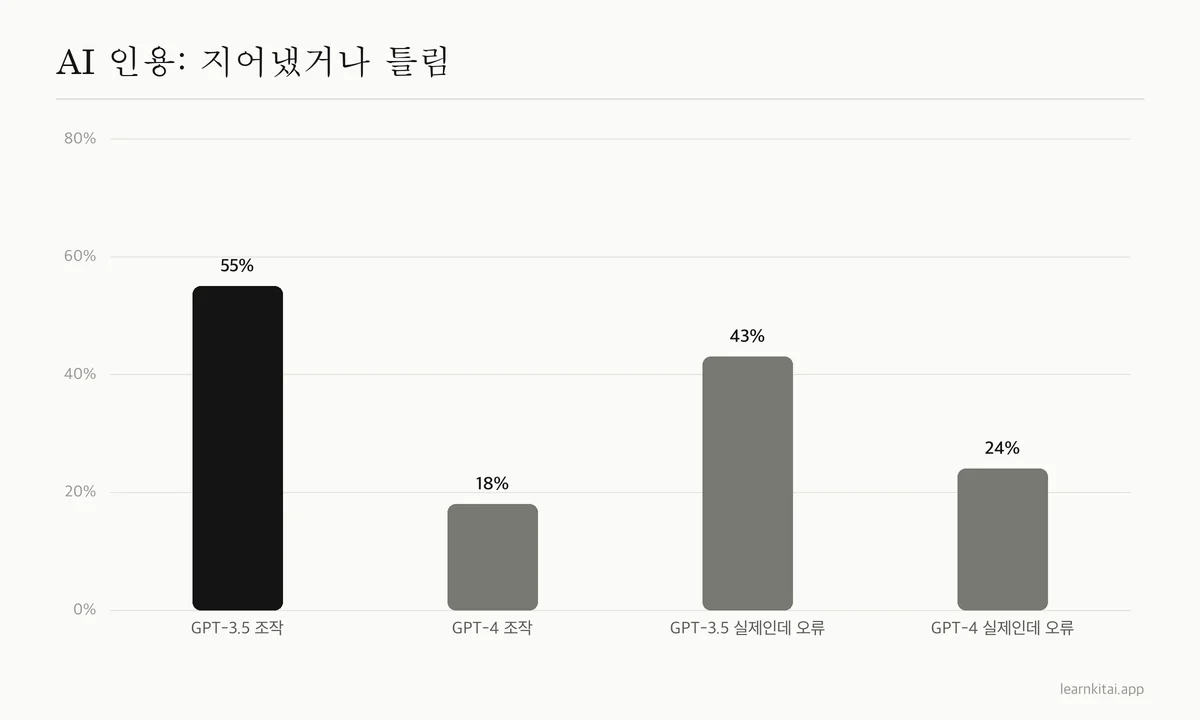
모델과 과제에 따라 크게 다릅니다. 한 유명한 테스트에서 이전 챗봇은 제시한 인용의 절반 넘게 지어냈고, 최신 모델도 다섯 개 중 거의 하나를 지어냈습니다. 출처가 붙지 않은 열린 질문이 가장 위험합니다.
인용은 가장 명확한 시험입니다. 참고 문헌은 있거나 없거나 둘 중 하나니까요. 연구자 월터스와 와일더는 ChatGPT에게 42개 주제에 대한 짧은 문헌 리뷰를 쓰게 하고 636개 참고 문헌을 모두 확인했습니다. 그 결과 GPT-3.5 인용의 55%와 GPT-4 인용의 18%가 조작된 것이었습니다. 실제로 존재하는 참고 문헌 중에서도 많은 수가 쪽수나 날짜 같은 세부 내용에 오류가 있었습니다.
최신 모델은 더 낫고, 내가 준 문서를 기반으로 작동하는 도구는 보통 기억에서 답하는 챗봇보다 사실에 가깝게 머뭅니다. 하지만 더 낫다는 것이 완벽하다는 뜻은 아닙니다. 확인하는 습관은 몇 분이 들 뿐이지만 건너뛰면 성적이 깎일 수 있습니다.
AI 공부 노트에서 오류는 어디에 숨어 있나요?
오류는 몇 군데에 몰립니다. 숫자와 단위, 이름과 날짜, 인용, 않는다나 오직 같은 작은 단어, 인과 관계 주장입니다. 이것부터 확인하면 대부분의 문제를 빨리 잡을 수 있습니다.
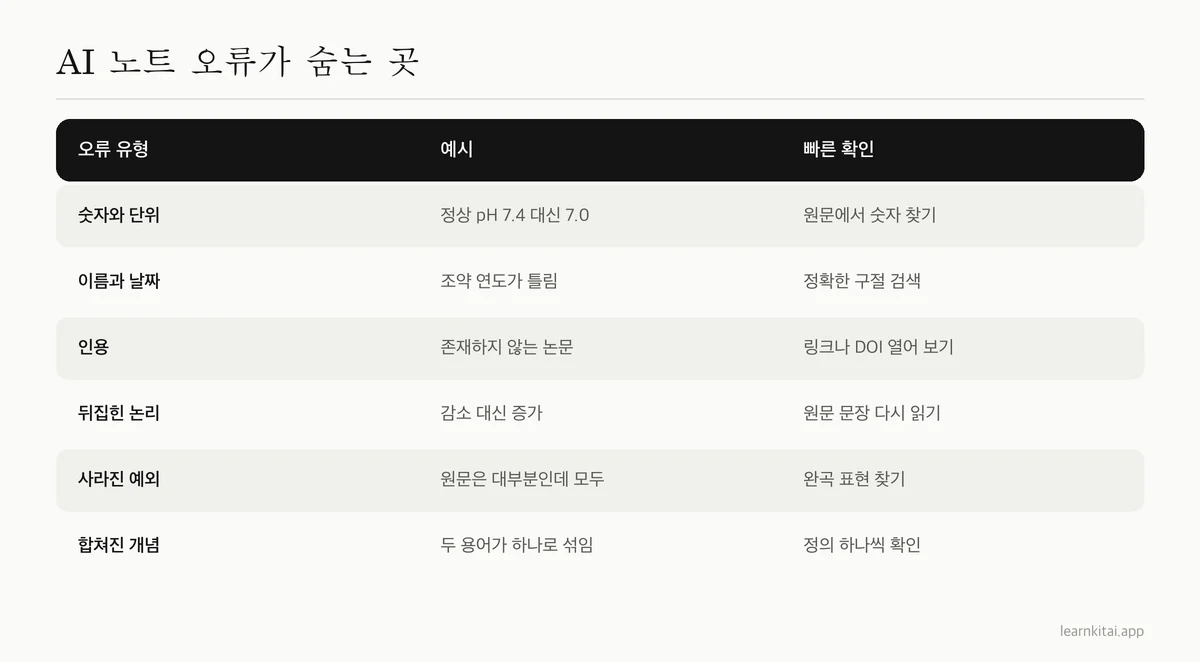
뒤집힌 논리는 특히 주의가 필요합니다. 생물학과 경제학 노트는 증가시킨다, 억제한다, 이어진다로 가득합니다. 화살표 하나가 뒤집힌 요약도 매끄럽게 읽히고, 나는 그것을 완전히 확신하며 외우게 됩니다.
AI 노트의 오류를 10분 안에 확인하려면?
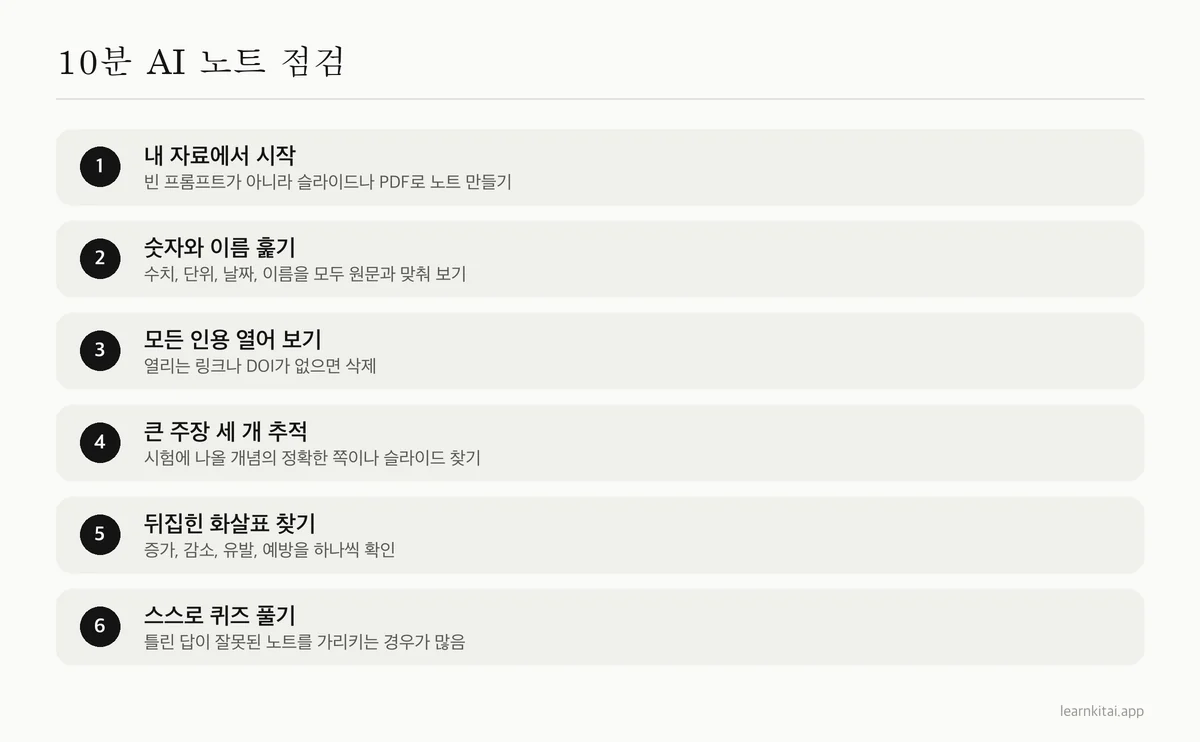
내 자료를 기준으로 하고, 숫자와 이름과 인용을 원문과 대조하세요. 핵심 주장 세 개를 정확한 쪽수까지 추적하고, 뒤집힌 논리를 찾고, 스스로 퀴즈를 푸세요. 노트에 확인 표시를 해서 한 번만 하면 되게 하세요.
실제 예시
생리학 강의의 AI 요약에 이런 문장이 있다고 해 봅시다. 인슐린은 췌장의 알파 세포에서 분비되어 혈당을 높인다. 2단계에서 알파 세포가 걸립니다. 슬라이드에는 베타 세포라고 쓰여 있습니다. 5단계에서 높인다가 걸립니다. 인슐린은 혈당을 낮추고, 높이는 것은 글루카곤입니다. 한 문장에 오류가 두 개이고, 훑어 읽으면 둘 다 괜찮아 보였을 겁니다. 원문을 열어 두었기 때문에 고치는 데 1분도 걸리지 않았습니다.
6단계는 조용한 영웅입니다. 노트로 스스로 퀴즈를 풀다가 어떤 답이 이상하게 느껴지면 노트가 아니라 원문으로 돌아가세요. 많은 학생이 이렇게 해서 꼼꼼히 다시 읽을 때 놓친 오류를 찾아냅니다. 찾은 오류는 오답 노트 쓰는 법대로 기록해서 오류가 아니라 수정된 내용을 기억하세요.
내 파일을 쓰면 AI가 더 정확한가요?
대체로 그렇습니다. AI 도구가 내가 준 문서를 바탕으로 작동하면 사실을 기억에서 꺼내지 않고 눈앞에 두고 있어서 지어낸 세부 내용이 줄어드는 경향이 있습니다. 오류가 없어지는 것은 아니므로 점검은 여전히 필요합니다.
그래서 첫 단계가 가장 중요합니다. 일반 챗봇에게 내 수업에 대해 물으면 학습 중에 흡수한 것에서 답하는데, 내 교과 계획서와 전혀 안 맞을 수 있습니다. 실제 강의 PDF를 주면 교수가 가르친 내용에 가깝게 머물 수 있습니다. 요약이 어떻게 어긋나고 무엇을 봐야 하는지는 AI 요약 정확도에서 더 깊이 다룹니다.
LearnKit이 이 방식으로 작동합니다. 내 PDF, 노트, 페이지 사진, 강의 녹음을 넣으면 그 자료로 요약, 플래시카드, 퀴즈를 만듭니다. 원문을 요약 옆에 두면 10분 점검이 쉬워집니다.
확인 없이는 AI를 믿으면 안 되는 것은 무엇인가요?
확인하지 않은 인용, 정확한 숫자, 인용문, 법이나 의학의 세부 사항, 시험에서 정밀하게 채점하는 모든 것을 믿지 마세요. AI가 가장 많이 틀리는 세부 내용이면서 점수를 가장 많이 잃게 하는 것들입니다.
- 참고 문헌과 인용문. 하나씩 열어 보세요. 존재하지 않으면 노트나 에세이에 절대 넣지 않습니다.
- 공식과 상수. 지수 하나가 틀리면 그것으로 푸는 모든 문제가 틀어집니다.
- 용량, 법률, 판례 이름. 정확성이 중요한데 AI는 비슷한 항목을 자주 섞습니다.
- 교수가 쓴 정의. 시험은 일반적인 표현이 아니라 수업의 표현을 기대하는 경우가 많습니다.
- 최근 사건. 모델은 학습 데이터가 끝난 뒤의 변화를 모를 수 있습니다.
이렇게 쓰면 AI는 진짜 시간을 아껴 줍니다. 빠른 요약과 즉석 퀴즈를 그대로 얻습니다. 속도 때문에 정확성을 잃지 않도록 10분의 확인만 더하면 됩니다. 내 루틴에서 AI가 어디에 맞는지는 AI로 공부하는 법을 읽어 보세요.
자주 묻는 질문
AI에게 자기 답을 직접 검증하게 해도 되나요?
조금은 도움이 됩니다. 예를 들어 각 주장의 원문 문장을 인용하게 할 수 있습니다. 하지만 모델은 같은 확신으로 자기 오류를 반복할 수 있습니다. 진짜 점검은 내가 원문과 직접 비교하는 것입니다.
AI 플래시카드가 AI 요약보다 믿을 만한가요?
본질적으로는 아닙니다. 카드는 짧아서 하나씩 확인하기 쉽지만, 틀린 카드는 반복을 통해 기억에 박힙니다. 첫 복습 세션 전에 카드를 확인하세요. 그 후가 아니라요.
수학에서도 AI 할루시네이션이 생기나요?
네. AI는 산수 실수를 하거나, 단계를 건너뛰거나, 틀린 공식을 자신 있게 말할 수 있습니다. 배울 계산은 직접 다시 풀고 공식은 교재와 대조하세요.
AI 노트에서 찾은 오류는 어떻게 신고하나요?
노트에서 바로 고치고, 굵게 표시하는 등 수정 사항을 분명히 표시하세요. 도구가 다시 생성하거나 편집을 지원한다면 카드나 요약을 갱신해서 나중에 틀린 버전을 복습하지 않게 하세요.
참고 자료
- Fabrication and errors in the bibliographic citations generated by ChatGPT, Walters and Wilder, Scientific Reports (via PubMed Central) (인용 636개 확인: GPT-3.5 인용의 55%, GPT-4 인용의 18%가 조작. 실제 인용 중 각각 43%와 24%에 실질적 오류.)
- Why Language Models Hallucinate, Kalai, Nachum, Vempala and Zhang, arXiv (학습과 평가가 불확실함을 인정하기보다 추측에 보상한다고 주장합니다.)
더 읽어 보기
AI 공부법: 대신 생각하게 말고 퀴즈를 내게 하세요
AI는 학생을 더 강하게도, 더 의존적으로도 만듭니다. 차이는 AI가 생각을 대신하느냐, 내가 생각하게 만드느냐입니다.
AI 요약 정확도: 무엇이 빠지고 어떻게 확인할까
AI 요약은 유창하고 빠르며 대체로 맞습니다. 어디서 틀리는지, 요약으로 공부하기 전에 할 5분 점검법을 알려 드립니다.
AI 과제 표절 기준: 도움과 부정행위의 경계
문제는 도구가 아니라, 내 생각이라며 제출하는 내용입니다. AI로 공부하면서 정직함을 지키는 간단한 판단법을 소개합니다.
오답 노트 쓰는 법: 틀린 문제를 점수로 바꾸세요
오답 노트는 틀린 문제와 이유를 적은 간단한 표입니다. 잘 쓰면 내가 가질 수 있는 가장 정확한 맞춤 공부 자료가 됩니다.